
Průšvih č. 1 - Box model
W3C je instituce, kde by měli ti, co zasahují do podoby webových technologií, dojednávat společné a pokud možno všeobecně přijatelné standardy. Tyto standardy jsou výtečnou věcí jednak pro vývojáře webových aplikací, kteří nemusí vymýšlet vícero verzí svých výtvorů, a jednak pro uživatele, kteří si mohou vybrat a používat prohlížeč dle svého vkusu a ne již podle toho, který z nich je nejvíce kompatibilní s jejich oblíbenými weby.
Že proklamovanou úlohu Konsorcium neplní, je nejzřetelněji znát na problémech okolo box modelu. Zatímco standardizátroři pracovali na svém box modelu,
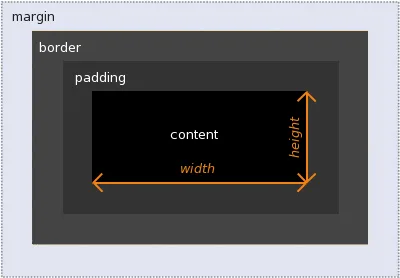
obr.1 - W3C box model
vývojáři webových prohlížečů tyto přípravy okázale ignorovali a rozhodli se jít vlastní cestou.

obr.2 - box model používaný režimem zpětné kompatibility
Rozdíl mezi oběma box modely je bohužel zcela zásadní. W3C šířkou rozumí šířku obsahu prvku, okrajové části - padding (výplň) a border (ohraničení) - už nezapočítává. Pro webdesignéry je toto pojetí hotovou katastrofou, protože k vizuálnímu uspořádání prvků na stránce potřebují znát jejich plnou šířku! Jak čas běžel a přednost dostávala sofistikovanější řešení (např. CSS layout před tabulkovým), jevila se potřeba respektování standardů stále naléhavější. Proto se prosadil i nepraktický standardní box model od W3C. Přechod se však neobešel bez potíží. Starší weby totiž byly uzpůsobeny pro druhý box model. Co s tím? Vyřešilo se to tak, že se stanovily dva renderovací režimy - standardní a zpětně kompatibilní. Jako přepínač mezi nimi slouží DOCTYPE deklarace. Ideální to samozřejmě z mnoha důvodů není. Kdyby na půdě Konsorcia existoval dialog, nemohlo by k takovým komplikacím nikdy dojít. Dobrou zprávou i přesto je, že si standardizátroři uvědomili, byť s ohromným zpožděním, že jejich počin není zrovna optimální, a vymysleli nápravu - CSS 3 definuje vlastnost box-sizing. Pokud se tato vlastnost použije s hodnotou border-box bude za šířku pojmuta plná šířka prvku. Hodnota se nedědí, takže je zapotřebí ji každému prvku deklarovat zvlášť - možná takto: body * {box-sizing: border-box}
Otázkou však zůstává, kolik vody uplyne, než tato vlastnost bude implementována ve všech prohlížečích. Prozatím webdesignérům nezbývá, než tento problém řešit matrjoškou.
Průšvih č. 2 - Sémantika
Idea sémantického webu spočívá, zjednodušeně vzato, v adekvátním popisu informací, které se nacházejí na webových stránkách. Tento popis by měl být zajištěn deskriptivními tagy. Jejich zásluhou by šlo informace snadno třídit a zpracovávat. Přínos by to mělo zejména pro vyhledávání. Pokud by si uživatel přál např. výpis všech známých citátů Winstona Churchilla, mohl by zadat vyhledávači, aby mu vypátral všechny citáty, u kterých je jako autor uveden Winston Churchill. Pro vyhledávač by to byl poměrně snadný úkol. Prostě by vypsal obsah všech prvků <q> a <blockquote>, ke kterým by bylo připojeno <cite>Winston Churchill</cite>.
Standardizátoři si však se sémantikou zahráli vskutku prapodivně. To, co dosavadní HTML nabízí, je pro důsledný sémantický popis takřka nepoužitelné. Ano, jsou zde v tomto smyslu užitečné tagy - třeba <a>, <abbr> nebo <address>, jenže celá řada důležitých tagů už dlouhá léta chybí, kupříkladu <date>. A jak zapsat v HTML písničku či básničku? Kde je tag pro reklamu? A kde tag pro viditelný text k obrázku (něco jako <caption> u tabulky)?
Z výše uvedeného by mohlo vyplývat, že myšlenka sémantického webu je za stávajících podmínek nerealizovatelná, nicmémě pesimismus není v tomto případě zcela na místě. I z mála se dá pomocí dobrých nápadů mnoho vytěžit. Krom toho, když chybí použitelná sémantika, proč nesáhnout po mikrosémantice? Mikroformáty budou mít brzy širokou podporu. A vůbec, web - to nejsou jen statické HTML dokumenty, sémantický princip lze uplatnit v leckteré webové aplikaci.
Sémantika není důležitá pouze pro pozdější extrakci dat, podstatná je i pro tvůrce webových stránek. Orientovat se v záplavě DIVů není přirozeně nic jednoduchého a tagy <header>, <footer>, <aside>, <menu> dostupné v HTML 5 určitě kód výrazně zpřehlední (tag <menu> je dostupný i v HTML 4 s výjimkou Strict verze, která je ovšem nejčastěji používáná).
Bohatší sémantika by měla ještě tu výhodu, že by se usnadnil přístup k prvkům. Ve spoustě případů by již nebylo nutné prvkům přidávat atributy id a class, neboť v CSS by jako selektor dostačovaly názvy tagů.
Podobného efektu by bylo dosaženo i u JavaScriptu. Občas je například jenom potřeba zkontrolovat, jestli jsou všechna políčka ve formuláři vyplněná. Komplikace spočívá v tom, že <input> má navzdory jednotnému názvu více podob a ty mají radikálně různé účely. Pro zmíněnou kontrolu je nejprve tedy nutné rozlišit vstupní políčka pro zadávání znaků (typy file, password, text) od tlačítek a zaškrtávátek.
Ačkoliv v HTML zatím mnoho tagů chybí, paradoxně jich tam také spousta přebývá. Jde především o tagy určující vzhled - <u>, <i> a podobné - ale i nad řadou dalších by se dalo diskutovat. Například <hr> plní spíše funkci grafickou a nic na tom nemění ani fakt, že si standardizátoři horizontal rule přejmenovali v XHTML 2 na separator. Roli oddělovače už navíc víceméně zastává <div> (=oddíl; division). Otazník visí i nad praktickým uplatněním tagu <var>, když neexistují k němu další tagy na řádné zmapování zdrojových kódů.
A další průšvihy?
Jistě, našly by se. Dalším tématem by mohla být pomalá práce na nových standardech, plivnout by se dalo i na rozhraní DOM. Má však smysl Konsorciu pořád jenom nadávat? Přece nádávat, to je mimořádně pubescentně tupé a ukazuje to na pokročilou míru demence, jak hlásá jeden guru, jenž sám nadávkami nešetří. Mnozí u této otázky zastávají jednoznačné ANO! Pár věcí by však měli vyjasnit. Když jim „nevoní“ W3C standardy, co by si vlastně přáli? MARQUEE nebo BLINK, document.all nebo document.layers? Či snad tohle?

















